
厂商:
备案号:
a-pdf scan paper电脑版是一款功能强大的文档扫描与OCR识别工具,专为Windows用户设计,能够将纸质文档、图片或PDF文件快速转换为可编辑的文本格式。软件内置高精度OCR引擎,支持多种语言识别,操作界面简洁直观,即使是新手也能轻松上手。无论是办公场景下的合同扫描、资料归档,还是个人使用中的书籍翻拍、笔记电子化,a-pdf scan paper都能提供高效、准确的解决方案。本篇文章将为您详细介绍该软件的下载安装步骤、核心功能、使用技巧以及常见问题解决方法,帮助您快速掌握这款实用工具。
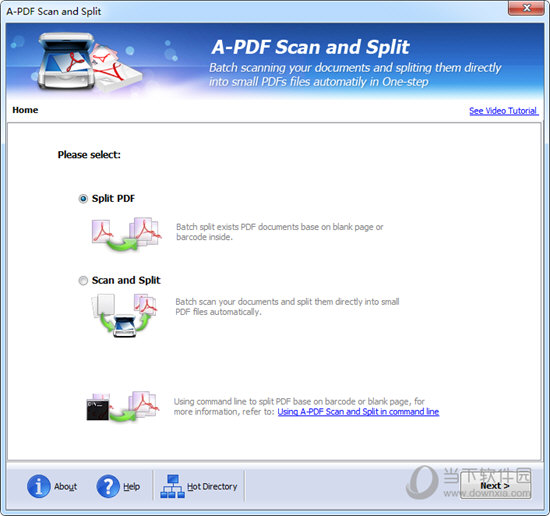
1. 首先,在浏览器中打开本站提供的下载链接,点击“下载”按钮,等待安装包下载完成。
2. 下载完成后,找到安装包文件(通常位于“下载”文件夹),双击运行安装程序。
3. 如果系统弹出用户账户控制提示,点击“是”以允许安装程序运行。
4. 进入安装向导后,点击“下一步”继续,阅读并同意软件许可协议,再次点击“下一步”。
5. 选择安装目录(建议使用默认路径),点击“下一步”,然后点击“安装”开始安装过程。
6. 等待安装进度条走完,点击“完成”按钮,软件即安装成功,可在桌面或开始菜单中找到快捷方式。
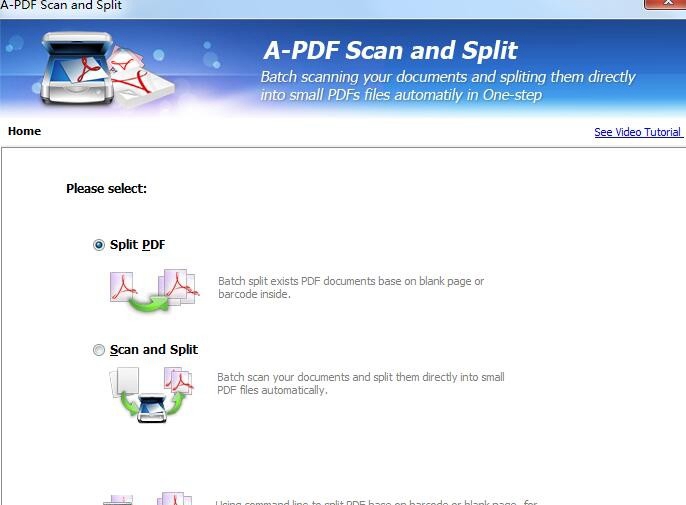
1. 打开a-pdf scan paper,在主界面选择“扫描”功能,您可以选择“从扫描仪扫描”或“从文件导入”两种模式。
2. 如果使用扫描仪,请确保设备已正确连接电脑,并安装好驱动程序,软件会自动识别设备。
3. 选择“从文件导入”可以导入已有的图片或PDF文件,支持JPG、PNG、BMP、TIFF等多种格式。
4. 在扫描设置中,您可以调整分辨率、色彩模式(黑白、灰度、彩色)以及输出格式(PDF、JPEG等)。
5. 点击“扫描”按钮,软件将开始扫描,预览区域会实时显示扫描效果,扫描完成后可进行后续编辑操作。
6. 扫描结果会自动保存到指定文件夹,您也可以在“设置”中自定义输出路径。
1. 在软件中打开需要识别的文档,点击工具栏上的“OCR”按钮,进入文字识别模式。
2. 在OCR设置中,选择文档语言(如中文、英文、中英混合等),同时可勾选“自动旋转”或“自动矫正”选项。
3. 点击“开始识别”按钮,软件将对当前页面进行文字提取,处理速度取决于文档页数和内容复杂度。
4. 识别完成后,文字会显示在右侧文本编辑区,您可以对识别结果进行复制、导出或直接编辑修改。
5. 如果需要识别整个文档,可以点击“批量识别”功能,一次性处理所有页面,大幅提高效率。
6. 识别结果可以导出为TXT、Word、PDF等格式,方便后续编辑和分享。

1. 在软件主界面点击“批量扫描”图标,进入批量处理模式。
2. 在批量扫描设置中,选择扫描来源(扫描仪或文件夹),并设置扫描参数,如分辨率、色彩模式等。
3. 如果您使用扫描仪,可以放入多页文档,软件会自动连续扫描所有页面;如果从文件夹导入,可一次选择多张图片。
4. 扫描完成后,所有页面会显示在缩略图列表中,您可以拖动调整页面顺序,或对每一页进行单独编辑。
5. 点击“合并为PDF”按钮,将所有页面合并为一个PDF文件,也可以选择直接保存为多张图片。
6. 在输出设置中,您还可以为每个页面添加页眉页脚、水印或页码,然后点击“保存”完成批量处理。
a-pdf scan paper对硬件配置要求不高,市面上的主流电脑均可流畅运行,以下是推荐的配置参考:
| 项目 | 最低配置 | 推荐配置 |
|---|---|---|
| 操作系统 | Windows 7/8/10 | Windows 10/11 64位 |
| 处理器 | 1 GHz 或以上 | 2 GHz 双核或以上 |
| 内存 | 2 GB | 4 GB 或以上 |
| 硬盘空间 | 500 MB 可用空间 | 1 GB 以上可用空间 |
| 扫描仪支持 | 兼容TWAIN协议 | 兼容WIA或TWAIN协议 |
 首页
 安卓游戏
 安卓软件
 热门专题
 更多
 鄂公网安备42011502001927号


